数据来源:Kaggle Ubiquant Market Prediction
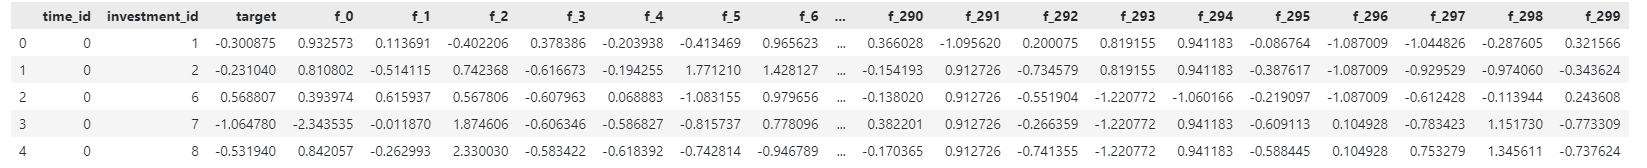
数据集描述了多个投资项目在一个时间序列下的300个匿名特征("f_0"至"f_299")以及一个目标特征("target")。要求根据后续时间节点的匿名特征预测目标特征。
本文的主要目标是构建特定长度的时间序列RNN网络训练和测试集。
由于给出的要求是预测后续时间点的目标特征,模型的建立是基于过去的模式在将来依然存在。因此,对于这样的模型,跨时间划分训练集、验证集和测试集是合理的。数据集中给出了时间序号("time_id")从0开始至1219,共计3141410条。取其中百分之二作为测试集,从时间序号1201至1219。
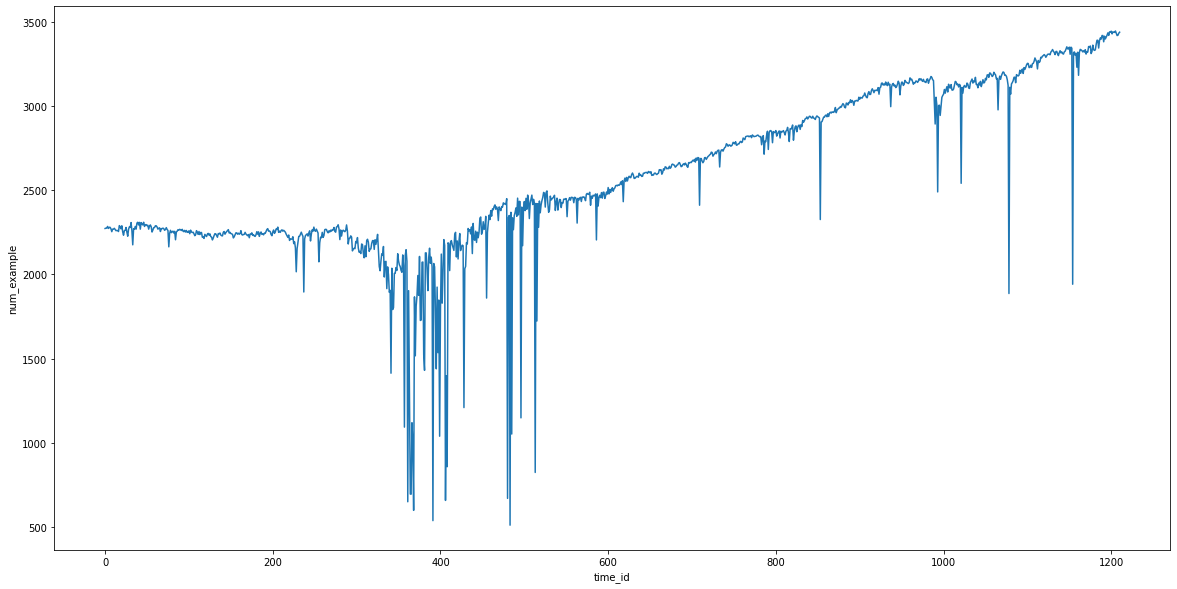
解决该问题的思路很简单。将该数据集中各投资项目视为独立的时间序列,可以先根据investment_id划分数据集,再在划分后的数据集上分别通过滑动窗口的方法获取定长的时间序列数据。
但在实际应用中会遇到一些问题。首先,通过滑动窗口的方法获取的时间序列数据有较大的重复性。假设目标的时间序列长度为20,若将窗口序列数据集直接写入磁盘会占用原数据集近二十倍的空间。
相对应的,在训练过程中完全采用实时计算获取窗口序列也不是一个可取的方法。计算窗口序列的过程会在每个epoch中重复执行,计算函数的效率直接影响到训练的速度。
一个折中的方案是只将窗口序列中各时间点的数据在原数据集中对应的序号的记录下来作为序号数据集写入磁盘。在训练过程中通过读取原数据集和序号数据集生成batch。
由于RNN网络允许不定长的时间序列作为输入,而非矩阵形式的批次回影响输入的效率,故通过全零填充未达到要求长度的窗口序列并为此在原数据集中插入一行全零行(注意:全零行的插入需要在标准化、归一化等预处理操作之后)。
MIN_LEN = 20 # 最小窗口序列长度,低于该长度的窗口序列会被全零行填充FEATURE_NUM = 300ZERO_INDEX = 3141410 # 全零行序号def form_indexes(data,time_range): # data:原数据集 time_range:时间序列范围 id_list = sorted(data['investment_id'].unique()) if 0 in id_list: id_list.remove(0) indexes_list = [] for id in tqdm(id_list): sub_data = data[data['investment_id']==id].sort_values(by=['time_id']) time_list = tuple(sorted(sub_data['time_id'].unique())) for t in range(time_range[0],time_range[1]): if t in time_list: i_t = time_list.index(t) temp = list(sub_data[max(i_t-MIN_LEN+1,0):i_t+1].index.values) indexes = [ZERO_INDEX]*(MIN_LEN-len(temp)) + temp return indexes_list在训练前构建窗口序列数据训练集和测试集(验证集)
通过tf.data.Dataset的from_generator方法构建数据集的益处在于只有在数据被使用时(读取或预读取)才会运行生成器函数,不会占用过多内存,同时shuffle和分批次等操作都能较为简便的完成。
train_indexset= pd.read_parquet('trainindex.parquet')val_indexset= pd.read_parquet('valindex.parquet')def gen_func(train_val_or_test): # 生成器函数 if train_val_or_test == 1: for indexes in train_indexset.iterrows(): features = data.iloc[indexes[1].values].values[:,4:] label = data.iloc[indexes[1].values[-1]]['target'] yield (features,label) elif train_val_or_test == 2: for indexes in val_indexset.iterrows(): features = data.iloc[indexes[1].values].values[:,4:] label = data.iloc[indexes[1].values[-1]]['target'] yield (features,label) else: print("error input") raise ValueError# 指定输出的形状和数据类型featureSpec = tf.TensorSpec( shape=[MIN_LEN,FEATURE_NUM], dtype=tf.dtypes.float32, name=None)labelSpec = tf.TensorSpec( shape=[], dtype=tf.dtypes.float32, name=None)train_data = tf.data.Dataset.from_generator(generator=gen_func,args=[1] ,output_signature=(featureSpec,labelSpec))val_data = tf.data.Dataset.from_generator(generator=gen_func,args=[2] ,output_signature=(featureSpec,labelSpec))以下模型和超参数只做展示用途所用,不具有指导意义。
MIN_LEN = 20FEATURE_NUM = 300BATCH_SIZE = 1000EPOCH_NUM = 50 def build_RNNmodel(): model = tf.keras.models.Sequential( [ tf.keras.layers.Masking(mask_value=0., input_shape=(MIN_LEN, FEATURE_NUM)), tf.keras.layers.LSTM(1024,activation='tanh', return_sequences=True, dropout=0.5, kernel_initializer=tf.initializers.TruncatedNormal(stddev=0.01), ), tf.keras.layers.LSTM(256,activation='tanh', dropout=0.5, kernel_initializer=tf.initializers.TruncatedNormal(stddev=0.01), ), tf.keras.layers.Dense(1,activation='relu') ] ) return modeltrain_batchs = train_data.batch(batch_size=BATCH_SIZE).prefetch(BATCH_SIZE)val_batchs = val_data.batch(batch_size=BATCH_SIZE).prefetch(BATCH_SIZE)# 设置prefetch可以预读取后续批次数据提高运行速度model = build_RNNmodel()model.compile(loss='mae', optimizer=tf.keras.optimizers.Adam(0.0001))history = model.fit(train_batchs,epochs=EPOCH_NUM,validation_data=val_batchs)这里只取了一部分整体数据的一部分作为演示,每个batch有1000条窗口序列,每个epoch有451个batch,运行一个epoch的时间约为530秒。