 Python中如何操作Redis&Redis原生命令,一篇就够了!
redis 是一个非关系型数据库(区别于mysql关系型数据库,关联关系,外键,表),nosql数据库(not only sql:不仅仅是SQL),数据完全内存存储(速度非常快),存数据的形式是key value的形式,
value有五大数据类型:字符串,列表,hash(python中的字典),集合,有序集合
使用redis的优势:
"""(1) 速度快,因为数据存在内存中,类似于字典,字典的优势就是查找和操作的时间复杂度都是O(1)(2) 支持丰富数据类型,支持string,list,set,sorted set,hash(3) 支持事务,操作都是原子性,所谓的原子性就是对数据的更改要么全部执行,要么全部不执行(4) 丰富的特性:可用于缓存,消息,按key设置过期时间,过期后将会自动删除"""redis 最适合的场景(主要做缓存,所以又叫缓存数据库)
"""(1)会话缓存(Session Cache)---》存session---》速度快(2)接口,页面缓存---》把接口数据,存在redis中(3)队列--->celery使用(4)排行榜/计数器--->个人页面访问量(5)发布/订阅"""??官网:Redis
??官网下载:Download | Redis
windows:作者不支持windwos本质原因:redis很快,使用了io多路复用中的epoll的网络模型,这个模型不支持win,所以不支持(看到高性能的服务器基本上都是基于io多路复用中的epoll的网络模型,nginx),微软基于redis源码,自己做了个redis安装包,但是这个安装包最新只到3.x,又有第三方组织做到最新5.x的安装包??win下载地址:
RDB:https://github.com/uglide/RedisDesktopManager/releases
Windows启动服务端:
找到服务面板,点击启动
命令启动:
redis-server redis.windows-service.conf# redis-server 配置文件Windows启动客户端:
命令行:redis-cli -p 端口 -h 地址客户端:rdb连接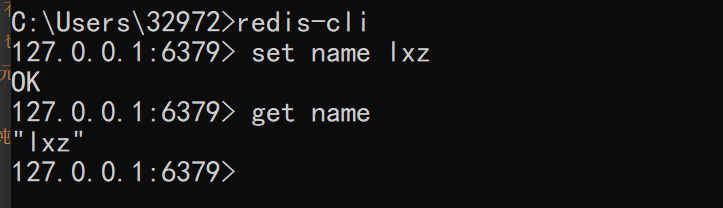
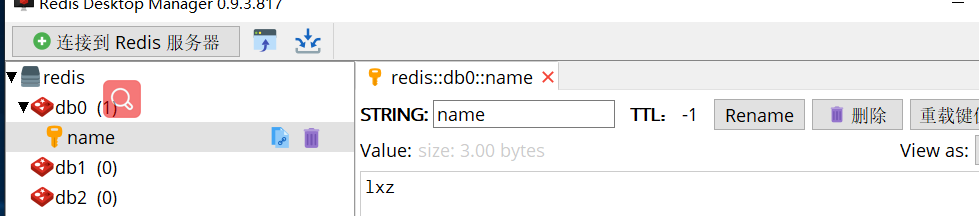
注意:一个键最大能存储 512MB
Python连接redis需要下载模块redis
pip install redis连接本地示例,也可以连接远端
方式一:Redis实例化
from redis import Redis# 普通连接conn = Redis( host="localhost", # 连接本地/远端 port=6379, # 端口 db=0, # 数据库 password=None, # 密码)conn.set('name','HammerZe')print(conn.get('name')) # b'HammerZe'方式二:使用连接池
# 连接池连接# 第一步:创建池POOL = redis.ConnectionPool(max_connections=10,host="localhost",port=6379, db=0)# 第二步,使用池,从池中拿一个连接conn = redis.Redis(connection_pool=POOL)print(conn.get('name')) # b'HammerZe'"""这里需要注意,使用POOL必须是单例模式,也就是说POOL必须是单例的且全局只能有一个实例,无论程序怎么执行,POOL始终是同一个对象!所以建议把构造连接池的代码单独放入一个py文件中,因为导入py文件就是天然的单例模式,同一个py文件是一个对象(原理是导入的时候通过.pyc编译了)"""# POOL单例模式'''redis_pool.py'''import redisPOOL = redis.ConnectionPool(max_connections=10,host="localhost",port=6379, db=0)'''导入使用'''import redisfrom redis_pool import POOL# 第二步,使用池,从池中拿一个连接conn = redis.Redis(connection_pool=POOL)print(conn.get('name')) # b'HammerZe'# 多线程from threading import Threadimport redisimport timefrom redis_pool import POOL def get_name(): conn=redis.Redis(connection_pool=POOL) print(conn.get('name'))for i in range(10): t=Thread(target=get_name) t.start()time.sleep(2)'''注意: py文件作为脚本文件的时候,不能使用相对导入,只能使用绝对导入,不然会报错,要从环境变量中开始导起 在pycharm中右键运行的脚本所在的目录,就会被加入到环境变量'''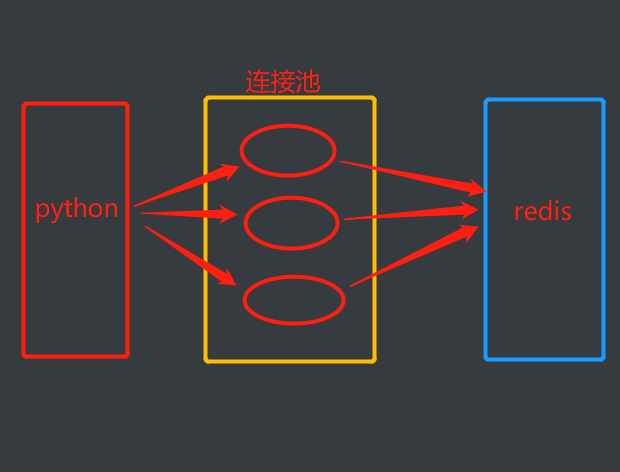
redis五大数据类型:字符串,列表,hash,集合,有序集合,下面介绍五大数据类型的基本操作:
Redis 键命令用于管理 redis 的键
语法:命令 键名
demo:
127.0.0.1:6379> SET mykey myvalueOK127.0.0.1:6379> DEL mykey(integer) 1# 在以上实例中 DEL 是一个命令, mykey 是一个键。 如果键被删除成功,命令执行后输出 (integer) 1,否则将输出 (integer) 0| 序号 | 命令及描述 |
|---|---|
| 1 | DEL key 该命令用于在 key 存在时删除 key。 |
| 2 | DUMP key 序列化给定 key ,并返回被序列化的值。 |
| 3 | EXISTS key 检查给定 key 是否存在。 |
| 4 | EXPIRE key seconds 为给定 key 设置过期时间,以秒计。 |
| 5 | EXPIREAT key timestamp EXPIREAT 的作用和 EXPIRE 类似,都用于为 key 设置过期时间。 不同在于 EXPIREAT 命令接受的时间参数是 UNIX 时间戳(unix timestamp)。 |
| 6 | PEXPIRE key milliseconds 设置 key 的过期时间以毫秒计。 |
| 7 | PEXPIREAT key milliseconds-timestamp 设置 key 过期时间的时间戳(unix timestamp) 以毫秒计 |
| 8 | KEYS pattern 查找所有符合给定模式( pattern)的 key 。 |
| 9 | MOVE key db 将当前数据库的 key 移动到给定的数据库 db 当中。 |
| 10 | PERSIST key 移除 key 的过期时间,key 将持久保持。 |
| 11 | PTTL key 以毫秒为单位返回 key 的剩余的过期时间。 |
| 12 | TTL key 以秒为单位,返回给定 key 的剩余生存时间(TTL, time to live)。 |
| 13 | RANDOMKEY 从当前数据库中随机返回一个 key 。 |
| 14 | RENAME key newkey 修改 key 的名称 |
| 15 | RENAMENX key newkey 仅当 newkey 不存在时,将 key 改名为 newkey 。 |
| 16 | [SCAN cursor MATCH pattern] [COUNT count] 迭代数据库中的数据库键。 |
| 17 | TYPE key 返回 key 所储存的值的类型。 |
语法:命令 键名
下表列出了常用的 redis 字符串命令:
| 序号 | 命令及描述 |
|---|---|
| 1 | SET key value 设置指定 key 的值。 |
| 2 | GET key 获取指定 key 的值。 |
| 3 | GETRANGE key start end 返回 key 中字符串值的子字符 |
| 4 | GETSET key value 将给定 key 的值设为 value ,并返回 key 的旧值(old value)。 |
| 5 | GETBIT key offset 对 key 所储存的字符串值,获取指定偏移量上的位(bit)。 |
| 6 | [MGET key1 key2..] 获取所有(一个或多个)给定 key 的值。 |
| 7 | SETBIT key offset value 对 key 所储存的字符串值,设置或清除指定偏移量上的位(bit)。 |
| 8 | SETEX key seconds value 将值 value 关联到 key ,并将 key 的过期时间设为 seconds (以秒为单位)。 |
| 9 | SETNX key value 只有在 key 不存在时设置 key 的值。 |
| 10 | SETRANGE key offset value 用 value 参数覆写给定 key 所储存的字符串值,从偏移量 offset 开始。 |
| 11 | STRLEN key 返回 key 所储存的字符串值的长度。 |
| 12 | [MSET key value key value ...] 同时设置一个或多个 key-value 对。 |
| 13 | [MSETNX key value key value ...] 同时设置一个或多个 key-value 对,当且仅当所有给定 key 都不存在。 |
| 14 | PSETEX key milliseconds value 这个命令和 SETEX 命令相似,但它以毫秒为单位设置 key 的生存时间,而不是像 SETEX 命令那样,以秒为单位。 |
| 15 | INCR key 将 key 中储存的数字值增一。 |
| 16 | INCRBY key increment 将 key 所储存的值加上给定的增量值(increment) 。 |
| 17 | INCRBYFLOAT key increment 将 key 所储存的值加上给定的浮点增量值(increment) 。 |
| 18 | DECR key 将 key 中储存的数字值减一。 |
| 19 | DECRBY key decrement key 所储存的值减去给定的减量值(decrement) 。 |
| 20 | APPEND key value 如果 key 已经存在并且是一个字符串, APPEND 命令将指定的 value 追加到该 key 原来值(value)的末尾。 |
demo
# 设置值127.0.0.1:6379> set name lxzOK# 获取值127.0.0.1:6379> get name"lxz"# 获取子字符串127.0.0.1:6379> getrange name 0 1"lx"# 设置新值,返回旧值127.0.0.1:6379> getset name HammerZe"lxz"# 获取多个值127.0.0.1:6379> mget name age1) "HammerZe"2) "18""""1 set(name, value, ex=None, px=None, nx=False, xx=False) ex,过期时间(秒) px,过期时间(毫秒) nx,如果设置为True,则只有name不存在时,当前set操作才执行,值存在,就修改不了,执行没效果 xx,如果设置为True,则只有name存在时,当前set操作才执行,值存在才能修改,值不存在,不会设置新值2 setnx(name, value)2 setex(name, value, time)3 psetex(name, time_ms, value)4 mset(*args, **kwargs)5 get(name)5 mget(keys, *args)6 getset(name, value)7 getrange(key, start, end)8 setrange(name, offset, value)9 setbit(name, offset, value)10 getbit(name, offset)11 bitcount(key, start=None, end=None)12 bitop(operation, dest, *keys)13 strlen(name)14 incr(self, name, amount=1)15 incrbyfloat(self, name, amount=1.0)16 decr(self, name, amount=1)17 append(key, value)"""import redisconn = redis.Redis(host="localhost",port=6379,db=0, )set相关操作
# conn.set('name','Hans') # 存值# conn.setex('age',5,18) # 设置过期时间5秒# conn.psetex('age',5000,18) # 设置过期时间为5000毫秒# print(conn.mget('name','age')) # 取值# conn.setnx('text','python')# conn.setnx('text','redis') # nx为true,text存在无法修改值,不存在可以修改# conn.set('text','redis1',xx=True) # xx为true,text不存之无法修改,存在可以修改# conn.mset({'text':'Linux','text1':'Python'}) # 批量设置# conn.setrange('hobby',0,'ball') # 从0位置开始设置ballget相关操作
# print(conn.get('text')) # b'Linux'# print(conn.mget(['text','text1'])) # [b'Linux', b'Python']# print(conn.mget('text','text1')) # [b'Linux', b'Python']# print(conn.getset('name','monkey')) # 获取原来的name,并设置成新值,b'Hans'# print(conn.get('name')) # b'monkey''''获取字节'''# print(conn.getrange('name',0,1)) # b'mo'# conn.set('name1','大帅逼')# print(conn.getrange('name1',0,2).decode('utf8')) # 大其他操作
"""统计字符串长度"""# 英文monkey# print(conn.strlen('name')) # 6# 汉字大帅逼# print(conn.strlen('name1')) # 9"""增值age+=1"""# print(conn.incr('age'))"""减值age-=1"""# print(conn.decr('age'))"""尾部追加"""# print(conn.append('name','nb')) # monkeynbRedis hash 是一个 string 类型的 field(字段) 和 value(值) 的映射表,hash 特别适合用于存储对象,类似python的字典;
Redis 中每个 hash 可以存储 232 - 1 键值对(40多亿)
demo:设置描述name的信息到哈希表test中
127.0.0.1:6379> hmset test name "hash" description "hashtable for test"OK127.0.0.1:6379> hgetall test1) "name"2) "hash"3) "description"4) "hashtable for test"127.0.0.1:6379>Hash常用方法
| 序号 | 命令及描述 |
|---|---|
| 1 | [HDEL key field1 field2] 删除一个或多个哈希表字段 |
| 2 | HEXISTS key field 查看哈希表 key 中,指定的字段是否存在。 |
| 3 | HGET key field 获取存储在哈希表中指定字段的值。 |
| 4 | HGETALL key 获取在哈希表中指定 key 的所有字段和值 |
| 5 | HINCRBY key field increment 为哈希表 key 中的指定字段的整数值加上增量 increment 。 |
| 6 | HINCRBYFLOAT key field increment 为哈希表 key 中的指定字段的浮点数值加上增量 increment 。 |
| 7 | HKEYS key 获取所有哈希表中的字段 |
| 8 | HLEN key 获取哈希表中字段的数量 |
| 9 | [HMGET key field1 field2] 获取所有给定字段的值 |
| 10 | [HMSET key field1 value1 field2 value2 ] 同时将多个 field-value (域-值)对设置到哈希表 key 中。 |
| 11 | HSET key field value 将哈希表 key 中的字段 field 的值设为 value 。 |
| 12 | HSETNX key field value 只有在字段 field 不存在时,设置哈希表字段的值。 |
| 13 | HVALS key 获取哈希表中所有值。 |
| 14 | [HSCAN key cursor MATCH pattern] [COUNT count] 迭代哈希表中的键值对。 |
demo
127.0.0.1:6379> hdel test name(integer) 1127.0.0.1:6379> hget test name(nil)127.0.0.1:6379> hgetall test1) "description"2) "hashtable for test"127.0.0.1:6379> hget test description"hashtable for test"127.0.0.1:6379> hkeys test1) "description"127.0.0.1:6379> hlen test(integer) 1127.0.0.1:6379> hmget test description1) "hashtable for test"127.0.0.1:6379> hmset test name "HammerZe" age 18OK127.0.0.1:6379> hmget test name description age1) "HammerZe"2) "hashtable for test"3) "18"127.0.0.1:6379> hset test name HammerZEZE(integer) 0127.0.0.1:6379> hvals test1) "hashtable for test"2) "HammerZEZE"3) "18"常用方法,都以h开头,存入多行数据无序
hset(name, key, value,mapping,items) # 设置值/多个值hmset(name, mapping) # 批量设置多个值hget(name,key) # 获取值hmget(name, keys, *args) # 获取多个值hgetall(name) # 获取所有值hlen(name) # 获取长度(键值对个数)hkeys(name) # 获取所有keyhvals(name) # 获取所有value值hexists(name, key) # 判断key是否存在于哈希表中hdel(name,*keys) # 删除一个值/多个值hincrby(name, key, amount=1) # 累加,通过指定amount的值hincrbyfloat(name, key, amount=1.0) # 累加浮点数hscan(name, cursor=0, match=None, count=None) # 获取部分值'''cursor:游标,cursor=0,代表从位置0开始取match:匹配规则count:取多少条数据注意:如果取100条,那么下次取会基于这次的游标位置继续往下取'''hscan_iter(name, match=None, count=None) # 取部分值,优化于hscan,可以一次取所有,也优化于hgetall设置count的值一般不会撑爆内存,内部使用的生成器yielddemo
import redisconn = redis.Redis(host="localhost",port=6379,db=1)# conn.hset('test','name','HammerZe') # 设置一个值# conn.hset('test',mapping={'age':19,'hobby':'ball'}) # 设置多个值# print(conn.hget('test', 'name')) # 获取值---->b'HammerZe'# print(conn.hmget('test',['name','age'])) # [b'HammerZe', b'19']# print(conn.hgetall('test')) # 获取所有值---》{b'name': b'HammerZe', b'age': b'19', b'hobby': b'ball'}# print(conn.hlen('test')) # 获取键值对个数---->3# print(conn.hkeys('test')) # 获取所有key--->[b'name', b'age', b'hobby']# print(conn.hvals('test')) # 获取所有value---->[b'HammerZe', b'19', b'ball']# print(conn.hexists('test','name')) # 判断该哈希表中是否有该key---->True# print(conn.hdel('test','name')) # 删除值# print(conn.hincrby('test','age',amount=2)) # 累加,每次加2岁 --->21# print(conn.hincrbyfloat('test','age',amount=2.2)) # 累加浮点数 --->23.2# hscan获取部分值# 写入值# for i in range(1000):# conn.hset('test1',f"key-->{i}",i)# hscan获取值# res=conn.hscan('test1', cursor=0, count=10)# print(res)# print(len(res[1])) # 100# hscan_iter: #全取出所有值,分批取,不是一次性全取回来,减小内存占用# res =conn.hscan_iter('test1',count=10)# print(res) # <generator object ScanCommands.hscan_iter at 0x0000015B14BD2D58># for i in res:# print(i)Redis列表是简单的字符串列表,按照插入顺序排序。你可以添加一个元素到列表的头部(左边)或者尾部(右边)
一个列表最多可以包含 232 - 1 个元素 (4294967295, 每个列表超过40亿个元素)。
Redis 列表命令
下表列出了列表相关的基本命令:
| 序号 | 命令及描述 |
|---|---|
| 1 | [BLPOP key1 key2 ] timeout 移出并获取列表的第一个元素, 如果列表没有元素会阻塞列表直到等待超时或发现可弹出元素为止。 |
| 2 | [BRPOP key1 key2 ] timeout 移出并获取列表的最后一个元素, 如果列表没有元素会阻塞列表直到等待超时或发现可弹出元素为止。 |
| 3 | BRPOPLPUSH source destination timeout 从列表中弹出一个值,将弹出的元素插入到另外一个列表中并返回它; 如果列表没有元素会阻塞列表直到等待超时或发现可弹出元素为止。 |
| 4 | LINDEX key index 通过索引获取列表中的元素 |
| 5 | LINSERT key BEFORE|AFTER pivot value 在列表的元素前或者后插入元素 |
| 6 | LLEN key 获取列表长度 |
| 7 | LPOP key 移出并获取列表的第一个元素 |
| 8 | [LPUSH key value1 value2] 将一个或多个值插入到列表头部 |
| 9 | LPUSHX key value 将一个值插入到已存在的列表头部 |
| 10 | LRANGE key start stop 获取列表指定范围内的元素 |
| 11 | LREM key count value 移除列表元素 |
| 12 | LSET key index value 通过索引设置列表元素的值 |
| 13 | LTRIM key start stop 对一个列表进行修剪(trim),就是说,让列表只保留指定区间内的元素,不在指定区间之内的元素都将被删除。 |
| 14 | RPOP key 移除列表的最后一个元素,返回值为移除的元素。 |
| 15 | RPOPLPUSH source destination 移除列表的最后一个元素,并将该元素添加到另一个列表并返回 |
| 16 | [RPUSH key value1 value2] 在列表中添加一个或多个值 |
| 17 | RPUSHX key value 为已存在的列表添加值 |
demo
127.0.0.1:6379> lpush testlist redis(integer) 1127.0.0.1:6379> lpush testlist mysql(integer) 2127.0.0.1:6379> lpush testlist python(integer) 3127.0.0.1:6379> lrange testlist 0 31) "python"2) "mysql"3) "redis"# 弹出值,如果没有10秒后返回nil127.0.0.1:6379> blpop testlist 101) "testlist"2) "python"127.0.0.1:6379> blpop testlist 101) "testlist"2) "mysql"127.0.0.1:6379> blpop testlist 101) "testlist"2) "redis"127.0.0.1:6379> blpop testlist 10(nil)(10.07s)常见方法
PS:图形界面看到的 上面是左,下面是右lpush(name,values) # 从列表左边插入lpushx(name,value) # 从列表左边插入,如果存在,才能操作llen(name) # 求长度linsert(name, where, refvalue, value) # 指定位置插入值 r.lset(name, index, value) # 对name对应的list中的某一个索引位置重新赋值r.lrem(name, count,value) # 删除 '''name:list名value:要删除的值num=0:要删除所有指定的值num=1:删除一个num=2:删除两个num=-2:从后往前删2个'''lpop(name) # 从左侧弹出rpop(name) # 从右侧弹出lindex(name, index) # 获取索引位置为index的值lindex('list',0)lrange(name, start, end) # 范围取,全闭区间ltrim(name, start, end) # 保留start-end范围内的值,移除其他值rpoplpush(src, dst) # 从一个列表取出最右边的元素,同时将其添加到另外一个列表的最左边blpop(keys, timeout) # 从左边弹出值,如果没有timeout秒后返回nil(生产者消费者模型,消息队列)brpoplpush(src, dst, timeout=0)demo
import redisconn = redis.Redis(host="localhost",port=6379,db=2)# conn.lpush('mylist','Hammer1','Hammer2')# conn.rpush('mylist','Hammer3')# conn.lpushx('mylist','Hammer4') # 存在name,从左边插入成功# print(conn.llen('mylist')) # 4# conn.linsert('mylist','before','Hammer4','Hammer5') # 在谁前插入# conn.linsert('mylist','after','Hammer5','Hammer6') # 在谁后插入# conn.lset('mylist',0,'位置0重新赋值')# conn.lrem('mylist',1,'位置0重新赋值') # 从左侧删除第一个值# conn.lrem('mylist',-1,'Hammer3') # 从右侧删除第一个值# conn.lrem('mylist','0','Hammer') # 从0开始,后面Hammer全删# res = conn.lpop('mylist') # 从左往外弹出# print(res) # b'Hammer5'# print(conn.lindex('mylist',1)) # 获取索引为1的值---> b'Hammer2'# print(conn.lrange('mylist',0,1)) # 获取范围内的值,[b'Hammer4', b'Hammer2']# conn.ltrim('mylist',0,1) # 除了范围内的,都删除# conn.blpop('mylist',timeout=2) # 阻塞式弹出,如果没有值,会一直阻塞# 作用,可以实现分布式的系统---》分布式爬虫# 爬网页,解析数据,存入数据库一条龙,一个程序做# 写一个程序,专门爬网页---》中间通过redis的列表做中转# 再写一个程序专门解析网页存入数据库公共操作与类型无关
常用方法
delete(*names) # 删除单个name或者多个nameexists(name) # 判断是否存在namekeys(pattern='*') # 获取匹配的key,不写默认获取所有,支持模糊匹配'''模糊查询:?代表匹配单个*代表匹配任意长度[ab]匹配ab:hel[ab]lo'''expire(name ,time) # 设置过期时间rename(src, dst) # name重命名,src原来的,dst新的move(name, db) # 把指定的name移动到指定db下randomkey() # 随机返回key值type(name) # 查看value类型demo
import redisconn = redis.Redis(host="localhost",port=6379,db=0)# conn.delete('age','test') # 删除age和test# print(conn.exists('age')) # 0# print(conn.exists('name','name1')) # 返回存在的个数--->2# conn.expire('name',3) # 设置3秒后,name过期# conn.rename('hobby','myhobby') # 重命名# conn.move('text',db=1) # 移动text到db1下# print(conn.randomkey()) # 随机返回key# print(conn.type('text1')) # b'string'Redis是非关系型数据库,本身是不支持事务,redis中的管道可以实现事务的支持,要么都成功要么都失败,那么实现的原理就是放入一个管道中一次性执行;
import redispool = redis.ConnectionPool() # 创建池conn = redis.Redis(connection_pool=pool) # 实例化pipe = conn.pipeline(transaction=True)pipe.multi() # 管道等待放入多条命令# 以后用pipe代替conn操作pipe.set('name', 'HammerZe')pipe.set('role', 'nb')# 到此是往管道中放了命令,还没执行,直到下面的命令pipe.execute() # 一次性执行管道中的所有命令"""如果是集群环境,不支持管道,数据过于分散,"锁不住""""【待续】