本系列的完结篇,介绍了连续控制情境下的强化学习方法,确定策略 DPG 和随机策略 AC 算法。
离散动作空间
连续动作空间
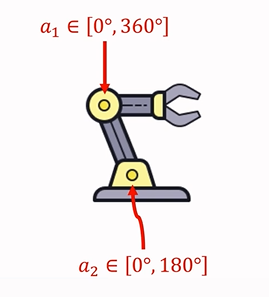
\(Action \ space \ \mathcal{A}=[0°,360°]×[0°,180°]\)
比如机械臂,如果具有两个运动关节:
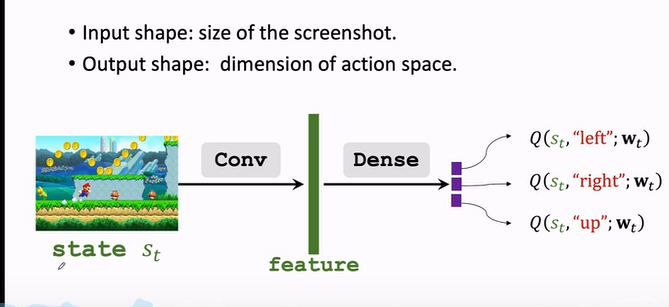
价值网络 DQN 可以解决离散动作控制的问题,因为 DQN 输出的是有限维度的向量。
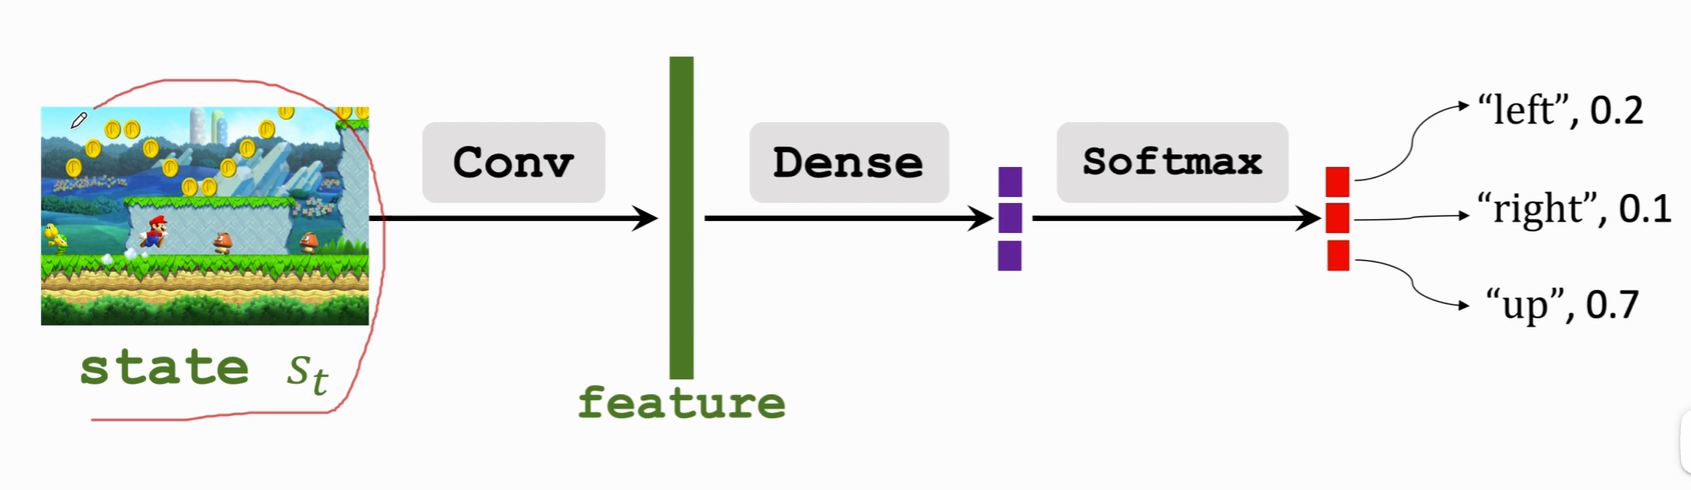
策略网络也同样。
所以此前的方法不能简单照搬到连续控制。要想应用到连续控制上,可以采用 连续空间离散化。
连续空间离散化:
另外还有两个方法:
Deterministic Policy Gradient.确定策略梯度,可以用于解决连续控制问题。后续引入深度神经网络,就是著名的 DDPG。
DPG 是 Actor-Critic 方法的一种。结构图如下:
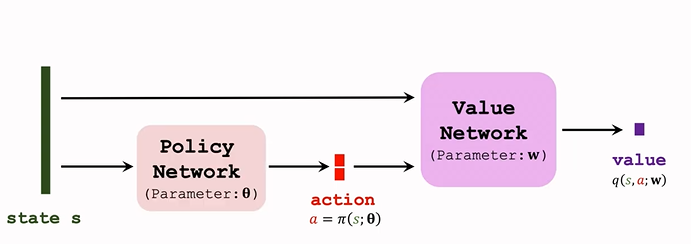
策略网络 actor
价值网络 critic
训练两个神经网络,让两个网络越来越好。
用 TD 算法更新 价值网络:
观测 transition:\((s_t,a_t,r_t,s_{t+1})\)
价值网络预测 t 时刻 的动作价值 \(q_t=q(s_t,a_t;w)\)
价值网络预测 t+1时刻的价值:\(q_{t+1}=q(s_{t+1},a'_{t+1};w)\)
注意这里的 \(a'_{t+1}\) 是 策略网络 t+1 时刻预选出来的动作,尚未执行。
TD error:\(\delta_t=q_t-\underbrace{(r_t+\gamma\cdot q_{t+1})}_{TD \ target}\)
更新参数:\(w\leftarrow w-\alpha\cdot\delta_t \cdot \frac{\partial q(s_t,a_t;w)}{\partial w}\)
策略网络用 DPG 算法 更新
对 DPG 算法进行推导。
训练价值网络的目标是,让价值网络的输出 q 越大越好。
而在DPG 的网络结构中,在给定状态时,动作是确定的(策略网络会给出一个确定的动作),且价值网络固定,那么影响输出的就是策略网络的参数 \(\theta\)。
所以更新 θ 使价值 q 更大;
计算价值网络关于 θ 的梯度 DPG:\(g=\frac{\partial q(s,\pi(s;\theta))}{\partial\theta}=\frac{\partial a}{\partial\theta}\cdot\frac{\partial q(s,a;w)}{\partial a}\)
链式法则,让梯度从价值 q 传播到动作 a;再从 a 传播到策略网络。
梯度上升更新 \(\theta\):\(\theta\leftarrow \theta+\beta\cdot g\)
上面的 DPG 是比较原始的版本,用 Target Network 可以提升效果。Target Network 在此前第11篇中讲过,上文中的算法也会出现高估问题或者低估问题。
因为用自身下一时刻的估计来更新此时刻的估计。
Target Network 方法的过程是:
同样,之前讲过的其他改进也可以用于这里,如经验回放、multi-step TD Target 等。
DPG 使用的是 确定策略网络,跟之前的随机策略不同。
| \ | 随机策略 | 确定策略 |
|---|---|---|
| 策略函数 | $\pi(a | s;\theta)$ |
| 输出 | 每个动作一个概率值,向量 | 确定的动作 |
| 控制方式 | 根据概率分布抽样a | 输出动作并执行 |
| 应用 | 大多是离散控制,用于连续的话结构大有不同 | 连续控制 |
这部分来介绍怎么在连续控制问题中应用随机策略梯度。
构造一个策略网络,来做连续控制,这个策略网络与之前学过的相差很大,以机械臂为例:
先从一个简单的情况研究起,自由度为1,这时动作都是实数 \(\mathcal{A}\subset \mathbb{R}\)
而机械臂的自由度通常是3或者更高,把自由度记为 d,动作 a 是一个 d 维的向量。
但是问题是,我们不知道 具体的 \(\mu , \sigma\),我们用神经网络来近似它们。
网络结构如下:
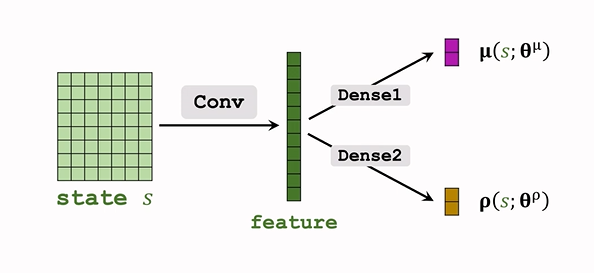
观测到 状态 s,输入神经网络;
神经网络输出 \(\hat\mu=\mu(s;\theta^\mu),\hat\rho=\rho(s;\theta^\rho)\),都是 d 维度
\(\hat\rho\) 计算 \(\hat\sigma_i^2=\exp(\hat\rho_i)\)
随机抽样得到动作 a :\(a_i\sim\mathcal{N}(\hat\mu_i,\hat\sigma_i^2)\)
这个正态分布是假定的策略函数。
Auxiliary Network, 计算策略梯度时对其求导。
随机策略梯度为:\(g(a)=\frac{\partial ln\pi(a|s;\theta)}{\partial\theta}\cdot Q_\pi(s,a)\)
计算 \(\pi\) 的对数。
策略网络为:\(\pi(A|s;\theta^\mu)=\Pi_{i=1}^d\frac{1}{\sqrt{6.28}}\cdot\exp(-\frac{(a_i--\mu)^2}{2\delta^2_i})\),输出是一个概率密度,表示在某点附近的可能性大小
虽然可以算出来某个动作的概率,但实际上我们只需要知道 均值 和 方差,来做随机抽样即可,所以实际上我们用不到这个策略函数 \(\pi\)
由上面策略梯度公式知:我们需要策略 \(\pi\) 的对数,所以训练时,我们会用到策略 \(\pi\) 的对数,而不是 \(\pi\) 本身:
由于神经网络输出的时方差对数\(\rho_i\),而不是\(\delta^2_i\),所以做个替换:\(\delta_i^2=\exp\rho_i\)
\(\ln\pi(a|s;\theta^\mu,\theta^\rho)=\sum_{i=1}^d[-\ln\delta_i-\frac{(a_i-\mu_i)^2}{2\delta^2}]+const\\=\sum_{i=1}^d[-\frac{\rho_i}{2}-\frac{(a_i-\mu_i)^2}{2\exp(\rho_i)}]+const\)
这样 神经网络的对数 就表示成了 \(\rho,\mu\) 的形式,记 \(\theta=(\theta^\mu,\theta^\rho)\)
把上式连加的一项记为 \(f(s,a;\theta)\),这就是辅助神经网络 Auxiliary Network.用于帮助训练。
\(f(a,s;\theta)=\sum_{i=1}^d[-\frac{\rho_i}{2}-\frac{(a_i-\mu_i)^2}{2\exp(\rho_i)}]\)
f 的输入是 s, a ,依赖于 \(\rho,\mu\),所以参数也是 \(\theta\)
结构如下:
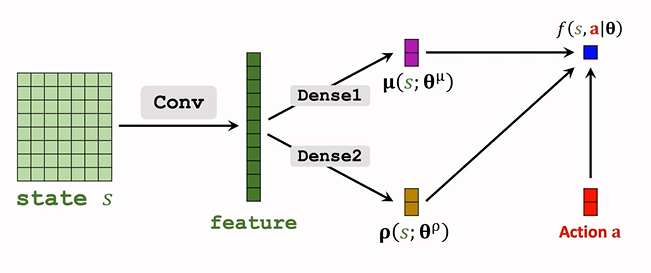
输入为 \(\underbrace{\mu,\rho}_{s},a\),输出为一个实数 f;
f 依赖于卷积层和全连接层的参数,所以接下来反向传播,可以算出 f 关于全连接层 Dense 参数的梯度,再算出 关于卷积层参数的梯度:
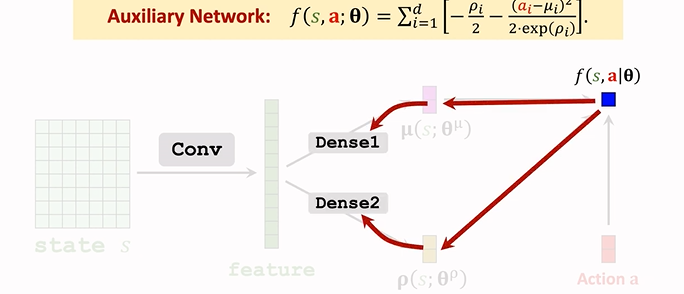
用 \(\frac{\partial f}{\partial \theta}\) 来表示梯度。
随机策略梯度:\(g(a)=\frac{\partial ln\pi(a|s;\theta)}{\partial\theta}\cdot Q_\pi(s,a)\)
辅助神经网路:\(f(s,a;\theta)=\ln\pi(a|s;\theta)+const\)
可以注意到,f 的梯度和 \(\ln\pi\) 的梯度相同,可以用前者梯度代替后者,即
而 f 作为一个神经网路,成熟的 pytorch 等可以对其自动求导。
Q 还未知,需对其做近似
连续动作空间有无穷多种动作数量
解决方案包括:
离散动作空间,使用标准DQN或者策略网络进行学习,但是容易引起维度灾难
使用确定策略网络进行学习
没有随机性,某些情境下不合适。
随机策略网络(\(\mu\) 与 \(\sigma^2\))
随机策略的训练过程:
本系列完结撒花!